


Views
No views yet

clean처리를 거친) Dataset을 공개하였습니다!| Size (용량) | NSMC (acc) | Naver NER (F1) | PAWS (acc) | KorNLI (acc) | KorSTS (spearman) | Question Pair (acc) | KorQuaD (Dev) (EM/F1) | |
|---|---|---|---|---|---|---|---|---|
| KcBERT-Base | 417M | 89.62 | 84.34 | 66.95 | 74.85 | 75.57 | 93.93 | 60.25 / 84.39 |
| KcBERT-Large | 1.2G | 90.68 | 85.53 | 70.15 | 76.99 | 77.49 | 94.06 | 62.16 / 86.64 |
| KoBERT | 351M | 89.63 | 86.11 | 80.65 | 79.00 | 79.64 | 93.93 | 52.81 / 80.27 |
| XLM-Roberta-Base | 1.03G | 89.49 | 86.26 | 82.95 | 79.92 | 79.09 | 93.53 | 64.70 / 88.94 |
| HanBERT | 614M | 90.16 | 87.31 | 82.40 | 80.89 | 83.33 | 94.19 | 78.74 / 92.02 |
| KoELECTRA-Base | 423M | 90.21 | 86.87 | 81.90 | 80.85 | 83.21 | 94.20 | 61.10 / 89.59 |
| KoELECTRA-Base-v2 | 423M | 89.70 | 87.02 | 83.90 | 80.61 | 84.30 | 94.72 | 84.34 / 92.58 |
| DistilKoBERT | 108M | 88.41 | 84.13 | 62.55 | 70.55 | 73.21 | 92.48 | 54.12 / 77.80 |
pytorch <= 1.8.0transformers ~= 3.0.1
transformers ~= 4.0.0 도 호환됩니다.emoji ~= 0.6.0soynlp ~= 0.0.4931from transformers import AutoTokenizer, AutoModelWithLMHead
2
3# Base Model (108M)
4
5tokenizer = AutoTokenizer.from_pretrained("beomi/kcbert-base")
6
7model = AutoModelWithLMHead.from_pretrained("beomi/kcbert-base")
8
9# Large Model (334M)
10
11tokenizer = AutoTokenizer.from_pretrained("beomi/kcbert-large")
12
13model = AutoModelWithLMHead.from_pretrained("beomi/kcbert-large")위 두 코드는 Pretrain 모델(base, large)와 batch size만 다를 뿐, 나머지 코드는 완전히 동일합니다.
ㄱ-ㅎ가-힣 으로 지정해 ㄱ-힣 내의 한자를 제외했습니다.ㅋㅋㅋㅋㅋ와 같이 중복된 글자를 ㅋㅋ와 같은 것으로 합쳤습니다.[UNK] 감소)pip install soynlp emojiclean 함수를 Text data에 사용해주세요.1import re
2import emoji
3from soynlp.normalizer import repeat_normalize
4
5emojis = list({y for x in emoji.UNICODE_EMOJI.values() for y in x.keys()})
6emojis = ''.join(emojis)
7pattern = re.compile(f'[^ .,?!/@$%~%·∼()\x00-\x7Fㄱ-ㅣ가-힣{emojis}]+')
8url_pattern = re.compile(
9 r'https?:\/\/(www\.)?[-a-zA-Z0-9@:%._\+~#=]{1,256}\.[a-zA-Z0-9()]{1,6}\b([-a-zA-Z0-9()@:%_\+.~#?&//=]*)')
10
11def clean(x):
12 x = pattern.sub(' ', x)
13 x = url_pattern.sub('', x)
14 x = x.strip()
15 x = repeat_normalize(x, num_repeats=2)
16 return xclean함수로 정제한 12GB분량의 txt 파일을 아래 Kaggle Dataset에서 다운받으실 수 있습니다 :)BertWordPieceTokenizer 를 이용해 학습을 진행했고, Vocab Size는 30000으로 진행했습니다.1/10로 샘플링한 데이터로 학습을 진행했고, 보다 골고루 샘플링하기 위해 일자별로 stratify를 지정한 뒤 햑습을 진행했습니다.1{
2 "max_position_embeddings": 300,
3 "hidden_dropout_prob": 0.1,
4 "hidden_act": "gelu",
5 "initializer_range": 0.02,
6 "num_hidden_layers": 12,
7 "type_vocab_size": 2,
8 "vocab_size": 30000,
9 "hidden_size": 768,
10 "attention_probs_dropout_prob": 0.1,
11 "directionality": "bidi",
12 "num_attention_heads": 12,
13 "intermediate_size": 3072,
14 "architectures": [
15 "BertForMaskedLM"
16 ],
17 "model_type": "bert"
18}1{
2 "type_vocab_size": 2,
3 "initializer_range": 0.02,
4 "max_position_embeddings": 300,
5 "vocab_size": 30000,
6 "hidden_size": 1024,
7 "hidden_dropout_prob": 0.1,
8 "model_type": "bert",
9 "directionality": "bidi",
10 "pad_token_id": 0,
11 "layer_norm_eps": 1e-12,
12 "hidden_act": "gelu",
13 "num_hidden_layers": 24,
14 "num_attention_heads": 16,
15 "attention_probs_dropout_prob": 0.1,
16 "intermediate_size": 4096,
17 "architectures": [
18 "BertForMaskedLM"
19 ]
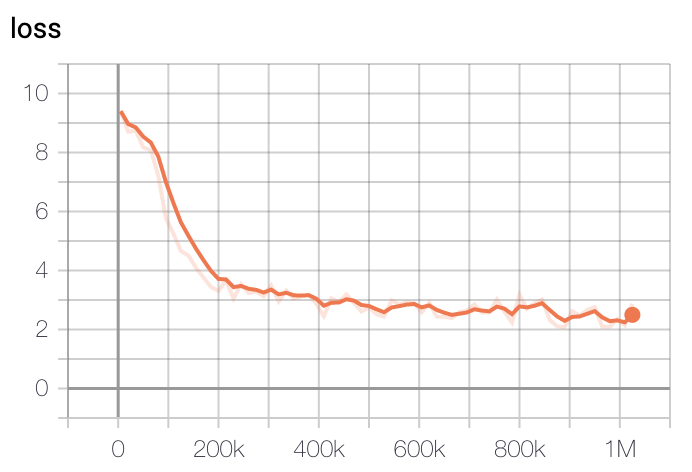
20}v3-8 을 이용해 각각 3일, N일(Large는 학습 진행 중)을 진행했고, 현재 Huggingface에 공개된 모델은 1m(100만) step을 학습한 ckpt가 업로드 되어있습니다.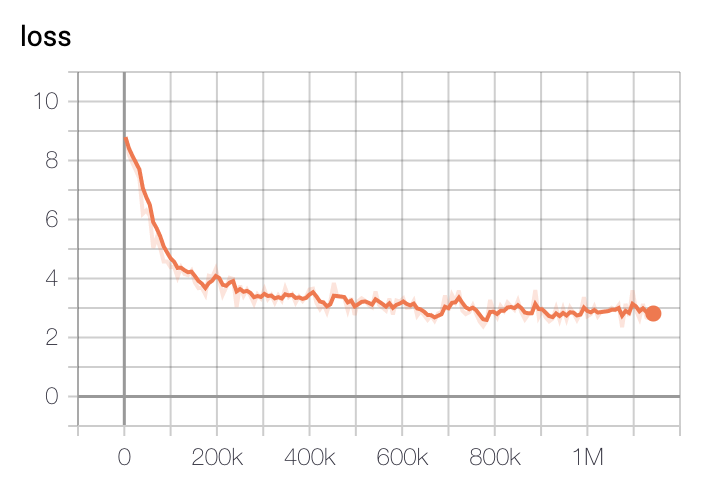
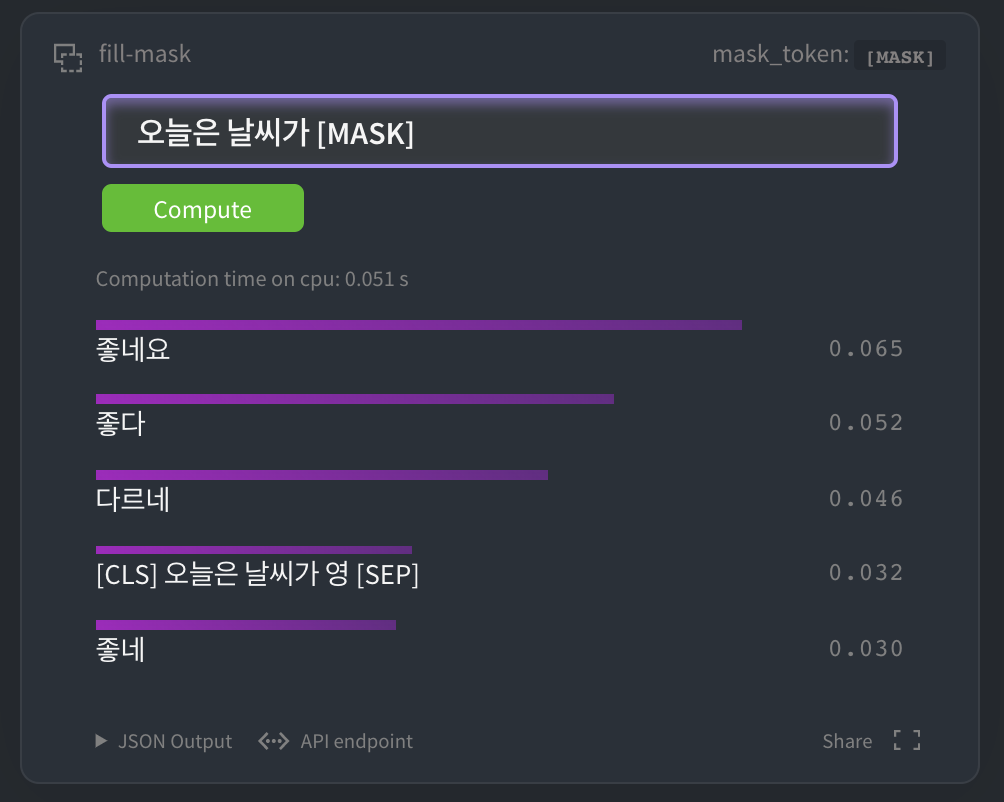
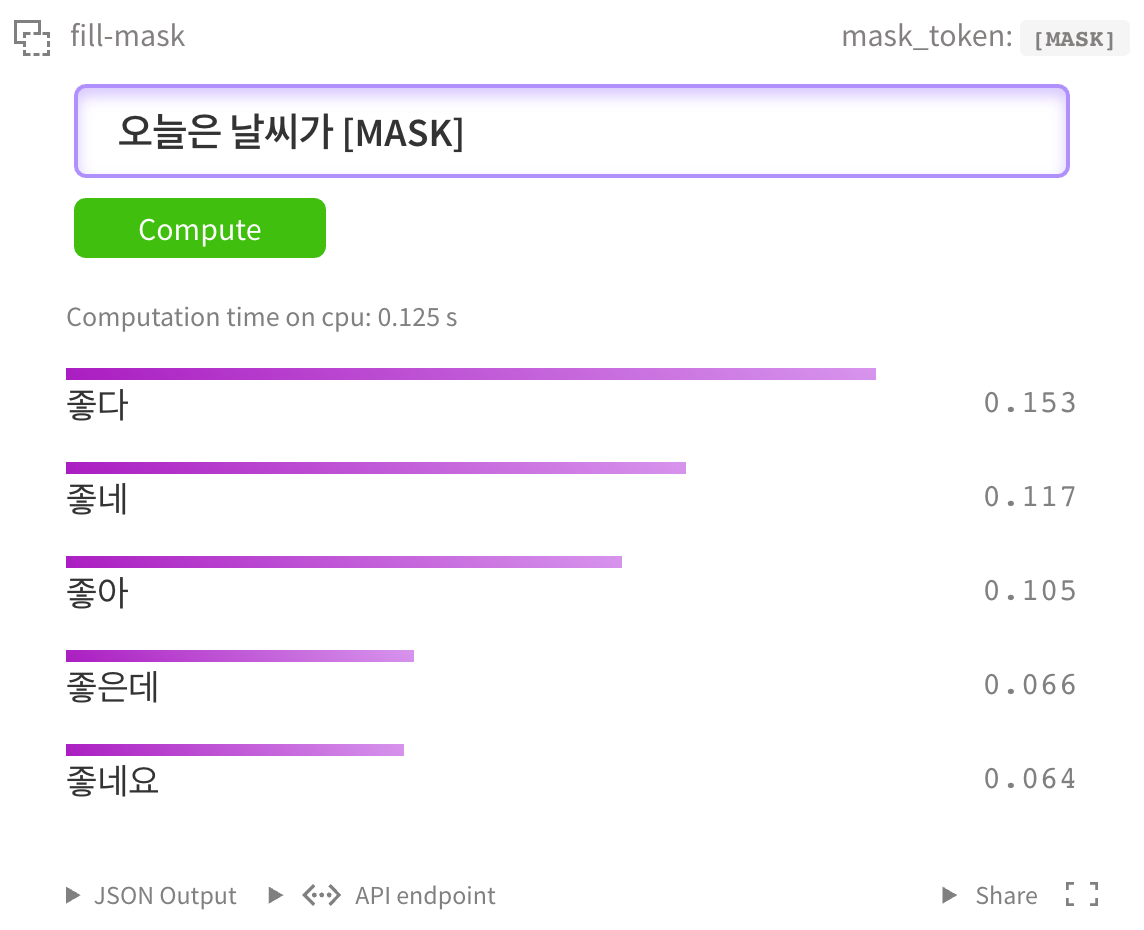
.8905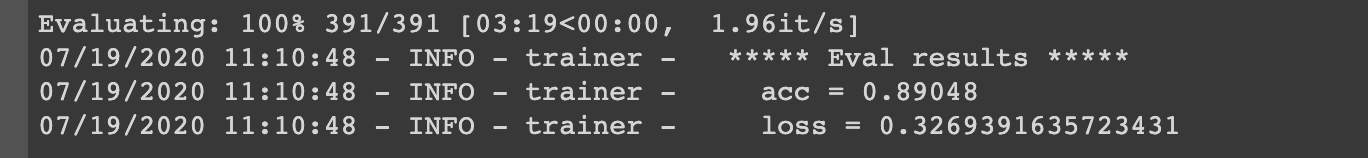
.9089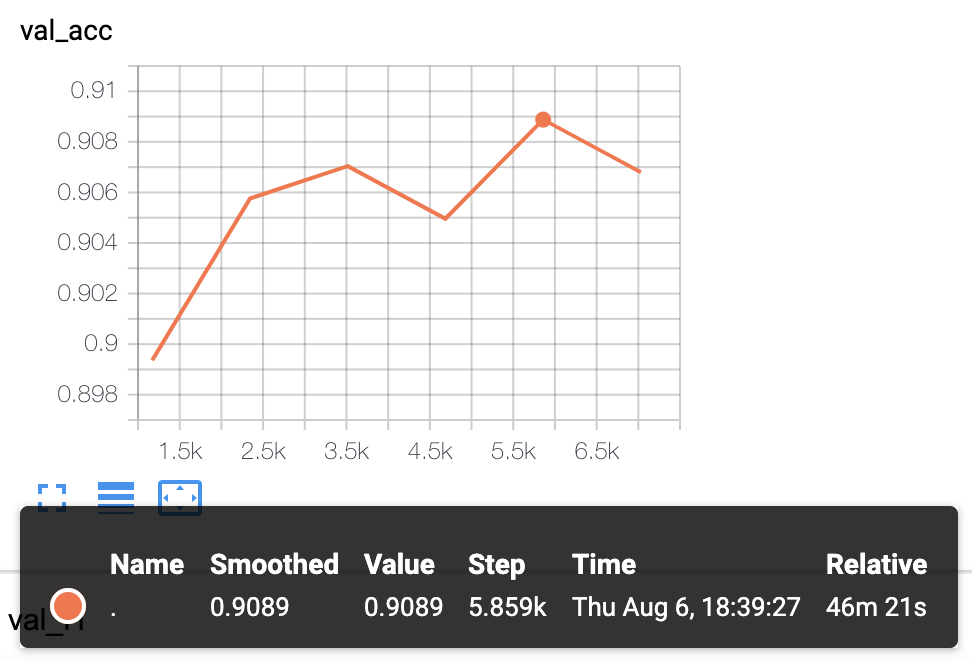
더 다양한 Downstream Task에 대해 테스트를 진행하고 공개할 예정입니다.
@inproceedings{lee2020kcbert,
  title={KcBERT: Korean Comments BERT},
  author={Lee, Junbum},
  booktitle={Proceedings of the 32nd Annual Conference on Human and Cognitive Language Technology},
  pages={437--440},
  year={2020}
}