


Views
No views yet
https://huggingface.co/beomi/KcELECTRA-base and v2022 Revision if needed.💡 NOTE 💡
General Corpus로 학습한 KoELECTRA가 보편적인 task에서는 성능이 더 잘 나올 가능성이 높습니다.
KcBERT/KcELECTRA는 User genrated, Noisy text에 대해서 보다 잘 동작하는 PLM입니다.| Size (용량) | NSMC (acc) | Naver NER (F1) | PAWS (acc) | KorNLI (acc) | KorSTS (spearman) | Question Pair (acc) | KorQuaD (Dev) (EM/F1) | |
|---|---|---|---|---|---|---|---|---|
| KcELECTRA-base-v2022 | 475M | 91.97 | 87.35 | 76.50 | 82.12 | 83.67 | 95.12 | 69.00 / 90.40 |
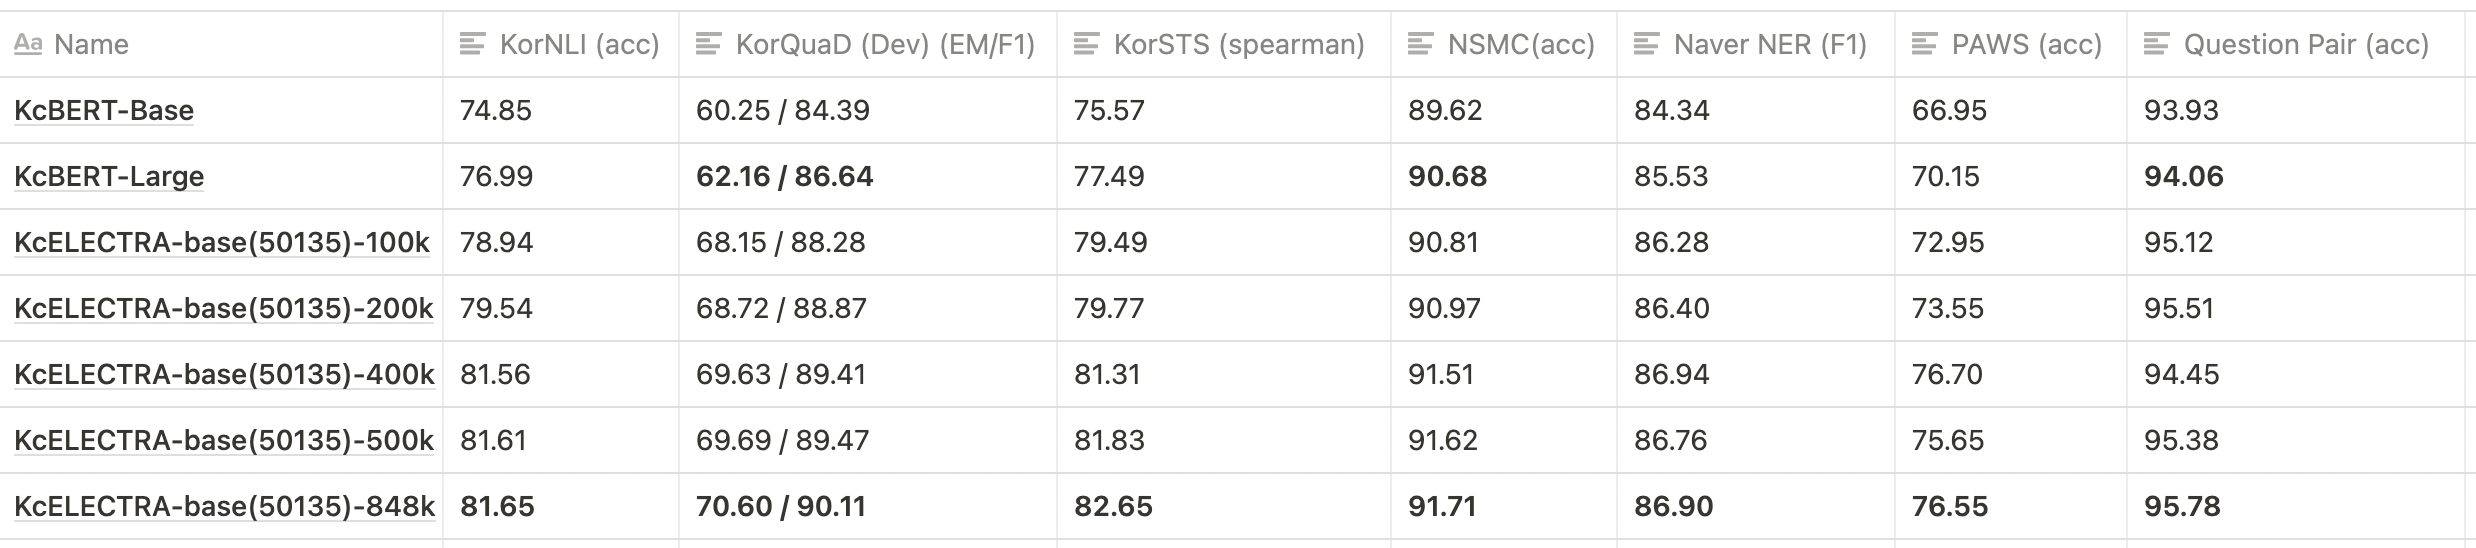
| KcELECTRA-base | 475M | 91.71 | 86.90 | 74.80 | 81.65 | 82.65 | 95.78 | 70.60 / 90.11 |
| KcBERT-Base | 417M | 89.62 | 84.34 | 66.95 | 74.85 | 75.57 | 93.93 | 60.25 / 84.39 |
| KcBERT-Large | 1.2G | 90.68 | 85.53 | 70.15 | 76.99 | 77.49 | 94.06 | 62.16 / 86.64 |
| KoBERT | 351M | 89.63 | 86.11 | 80.65 | 79.00 | 79.64 | 93.93 | 52.81 / 80.27 |
| XLM-Roberta-Base | 1.03G | 89.49 | 86.26 | 82.95 | 79.92 | 79.09 | 93.53 | 64.70 / 88.94 |
| HanBERT | 614M | 90.16 | 87.31 | 82.40 | 80.89 | 83.33 | 94.19 | 78.74 / 92.02 |
| KoELECTRA-Base | 423M | 90.21 | 86.87 | 81.90 | 80.85 | 83.21 | 94.20 | 61.10 / 89.59 |
| KoELECTRA-Base-v2 | 423M | 89.70 | 87.02 | 83.90 | 80.61 | 84.30 | 94.72 | 84.34 / 92.58 |
| KoELECTRA-Base-v3 | 423M | 90.63 | 88.11 | 84.45 | 82.24 | 85.53 | 95.25 | 84.83 / 93.45 |
| DistilKoBERT | 108M | 88.41 | 84.13 | 62.55 | 70.55 | 73.21 | 92.48 | 54.12 / 77.80 |
pytorch ~= 1.8.0transformers ~= 4.11.3emoji ~= 0.6.0soynlp ~= 0.0.4931from transformers import AutoTokenizer, AutoModel
2
3tokenizer = AutoTokenizer.from_pretrained("beomi/KcELECTRA-base")
4model = AutoModel.from_pretrained("beomi/KcELECTRA-base")💡 이전 KcBERT 관련 코드들에서AutoTokenizer,AutoModel을 사용한 경우.from_pretrained("beomi/kcbert-base")부분을.from_pretrained("beomi/KcELECTRA-base")로만 변경해주시면 즉시 사용이 가능합니다.

KcBERT는 2019.01-2020.06의 텍스트로, 정제 후 약 9천만개 문장으로 학습을 진행했습니다.
ㄱ-ㅎ가-힣 으로 지정해 ㄱ-힣 내의 한자를 제외했습니다.ㅋㅋㅋㅋㅋ와 같이 중복된 글자를 ㅋㅋ와 같은 것으로 합쳤습니다.OOO 제거OOO 로 표시합니다. 이 부분을 공백으로 제거하였습니다.[UNK] 감소)pip install soynlp emojiclean 함수를 Text data에 사용해주세요.1import re
2import emoji
3from soynlp.normalizer import repeat_normalize
4
5emojis = ''.join(emoji.UNICODE_EMOJI.keys())
6pattern = re.compile(f'[^ .,?!/@$%~%·∼()\x00-\x7Fㄱ-ㅣ가-힣{emojis}]+')
7url_pattern = re.compile(
8 r'https?:\/\/(www\.)?[-a-zA-Z0-9@:%._\+~#=]{1,256}\.[a-zA-Z0-9()]{1,6}\b([-a-zA-Z0-9()@:%_\+.~#?&//=]*)')
9
10import re
11import emoji
12from soynlp.normalizer import repeat_normalize
13
14pattern = re.compile(f'[^ .,?!/@$%~%·∼()\x00-\x7Fㄱ-ㅣ가-힣]+')
15url_pattern = re.compile(
16 r'https?:\/\/(www\.)?[-a-zA-Z0-9@:%._\+~#=]{1,256}\.[a-zA-Z0-9()]{1,6}\b([-a-zA-Z0-9()@:%_\+.~#?&//=]*)')
17
18def clean(x):
19 x = pattern.sub(' ', x)
20 x = emoji.replace_emoji(x, replace='') #emoji 삭제
21 x = url_pattern.sub('', x)
22 x = x.strip()
23 x = repeat_normalize(x, num_repeats=2)
24 return x💡 Finetune Score에서는 위clean함수를 적용하지 않았습니다.
BertWordPieceTokenizer 를 이용해 학습을 진행했고, Vocab Size는 30000으로 진행했습니다.v3-8 을 이용해 약 10일 학습을 진행했고, 현재 Huggingface에 공개된 모델은 848k step을 학습한 모델 weight가 업로드 되어있습니다.KcBERT-finetune repo를 참고해주세요.)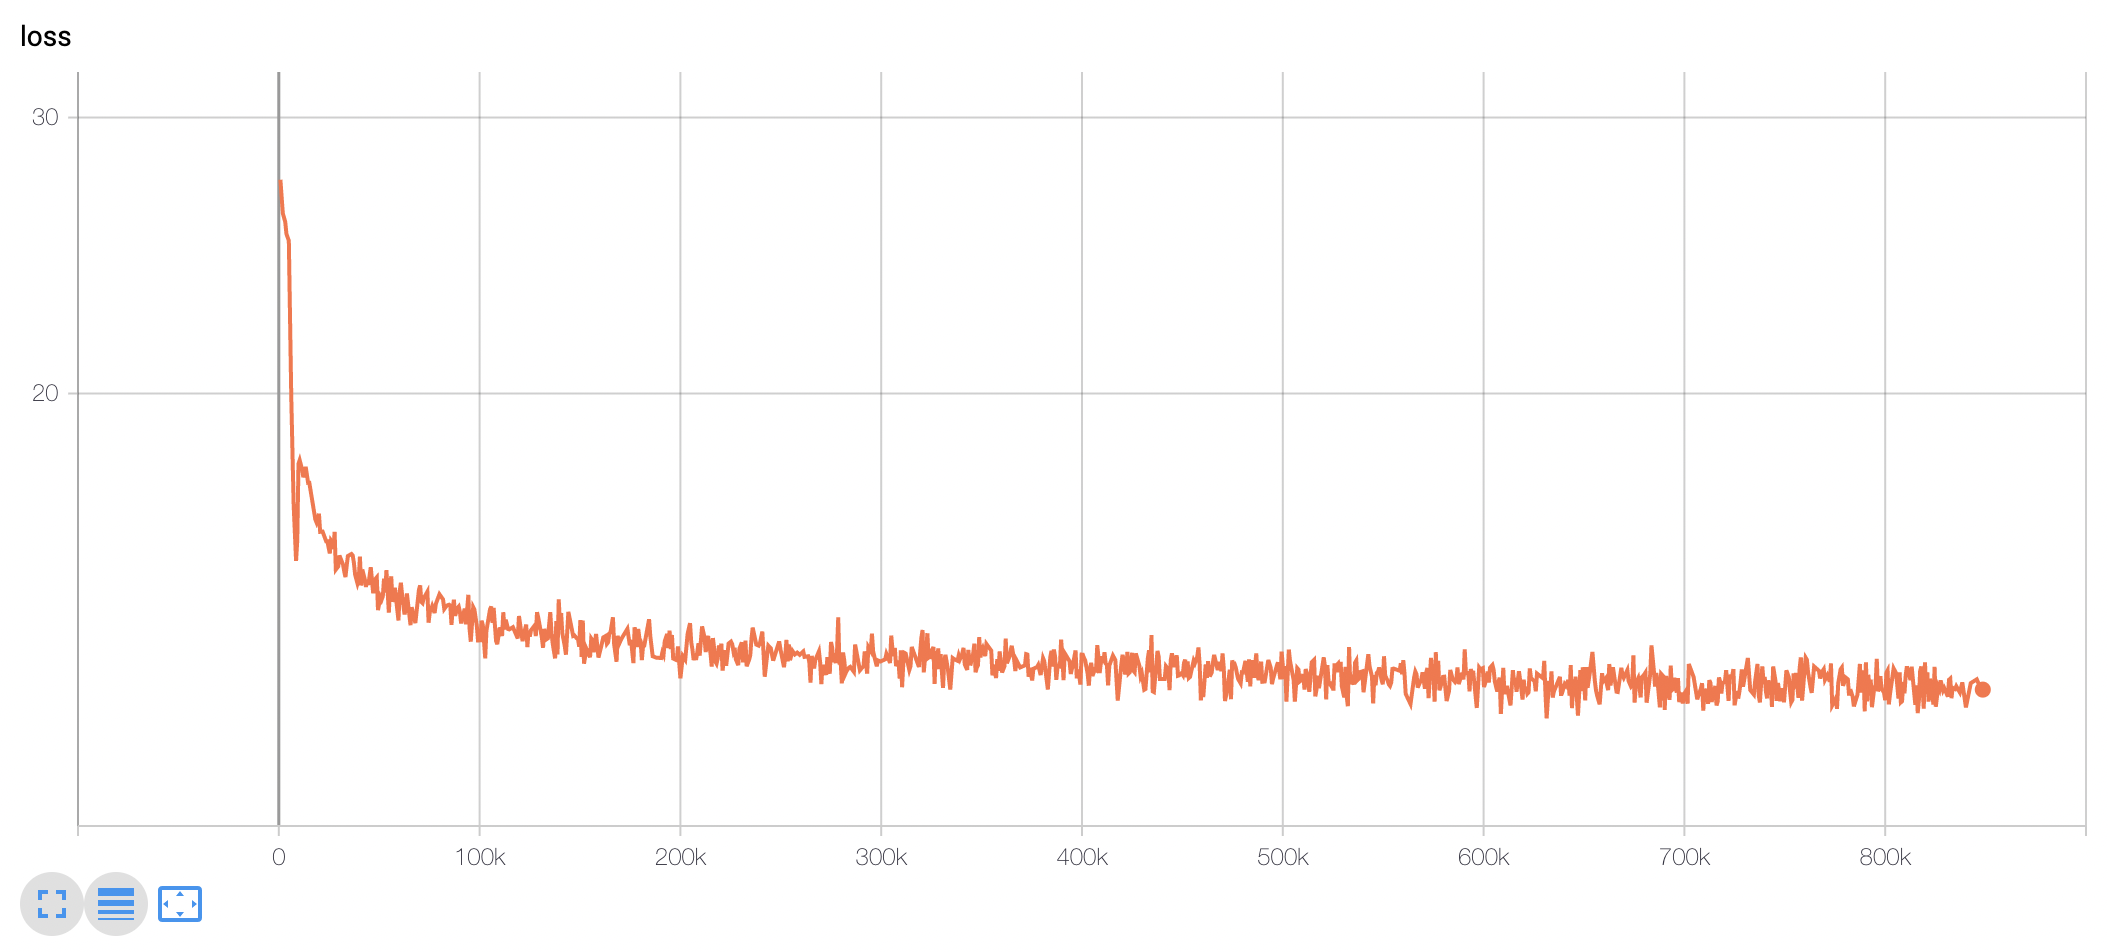
💡 아래 표는 전체 ckpt가 아닌 일부에 대해서만 테스트를 진행한 결과입니다.
@misc{lee2021kcelectra,
  author = {Junbum Lee},
  title = {KcELECTRA: Korean comments ELECTRA},
  year = {2021},
  publisher = {GitHub},
  journal = {GitHub repository},
  howpublished = {\url{https://github.com/Beomi/KcELECTRA}}
}